Fehler und Logs
Was Fadenstack selbst repariert, wenn ein Teil eines Clusters ausfällt, was Sie dabei sehen, was Ihnen überlassen bleibt und wo Sie die Logs lesen, wenn Sie sie brauchen.
Was sich selbst repariert
Jede Minute sieht sich Fadenstack jeden laufenden Cluster und jedes aktive Modell an, und zusätzlich, wenn sich eine Maschine wieder verbindet oder der Server startet. Eine solche Prüfung startet nur dann etwas neu, wenn etwas nicht stimmt, und Fadenstack prüft ein zweites Mal, bevor es irgendetwas neu startet: Ein ausgelasteter Head, der langsam geantwortet hat, ist kein ausgefallener.
| Was ausfällt | Was Sie sehen | Was Fadenstack tut |
|---|---|---|
| Eine Modellkopie stürzt ab | Die Bereitstellung zeigt weniger Kopien, dann wieder alle | Nichts: Ray startet die Kopie neu |
| Ray stoppt auf einer Maschine, die nicht der Head ist, oder ihre Netzwerkverbindung fällt aus | Der Cluster zeigt Braucht Aufmerksamkeit: „Maschine has dropped out of the cluster“ | Nimmt die Maschine aus Ray und lässt sie wieder beitreten, sobald das möglich ist. Kopien auf den anderen Maschinen bedienen weiter Anfragen |
| Der Head von Ray stoppt | Braucht Aufmerksamkeit: „Ray on Maschine, the cluster's head, is not running. Checking again before restarting anything“, dann „Restarting the cluster (attempt 1 of 3)“ | Stoppt Ray überall, startet einen neuen Head, lässt die anderen Maschinen beitreten und wendet die Modelle erneut an |
| Die Head-Maschine startet neu | Die Maschine zeigt Offline, danach wie oben, sobald sie wieder da ist | Wie oben |
| Der Agent einer Maschine startet neu | Nichts | Sieht sich den Cluster an, findet ihn in Ordnung, startet nichts neu |
| Die Dienste des Servers starten neu, oder der Server wird aktualisiert | Nichts an den Clustern | Wartet, bis sich die Maschinen wieder verbinden, und sieht dann nach. Nichts wird neu gestartet oder erneut angewendet |
| Das Gateway startet neu | Chat- und API-Anfragen schlagen fehl, solange es nicht läuft | Nichts nötig |
| Die Verbindung zwischen einer Maschine und dem Server bricht ab | Die Maschine zeigt Offline, wenn sie wegbleibt | Was die Maschine gerade tat, z. B. ein Modell kopieren, läuft weiter; das Ergebnis wird gemeldet, wenn sie sich wieder verbindet |
Nach einem Ausfall des Heads entfällt der größte Teil der Unterbrechung auf das erneute Laden der Modelle; der Cluster selbst ist viel früher wieder da.
Während ein Cluster neu gestartet wird, zeigen seine Modelle Not serving, und das Gateway schickt ihnen keine Anfragen mehr. Auf einen Cluster, der nicht bereit ist, wird nichts angewendet, und nichts wird angewendet, solange eine seiner Maschinen offline ist: Das Modell meldet „Waiting for Maschine to reconnect before applying.“ und macht weiter, sobald sie wieder verbunden ist.
Wenn Fadenstack es nicht reparieren kann
Nach drei Neustarts, die den Head nicht zurückgebracht haben, zeigt der Cluster Fehlgeschlagen:
Ray on Maschine, the cluster's head, is not running. Fadenstack restarted it 3 times and it did not come back (last: …). It tries again every 15 minutes; use Try again once the cause is fixed.
Fadenstack versucht es weiterhin alle 15 Minuten, weil die Ursache verschwinden kann, ohne dass jemand Fadenstack Bescheid gibt, etwa eine Netzwerkverbindung, die wieder da ist. Beheben Sie die Ursache und wählen Sie dann Erneut versuchen auf der Seite des Clusters.
Es startet nichts neu, wenn niemand auf seine Prüfung geantwortet hat: Dann ist über Ray nichts bekannt, und das Modell meldet „Could not check the model just now; it is looked at again within a minute.“
Was Ihnen überlassen bleibt
- Eine Maschine, die nicht zurückkommt: eine defekte Festplatte, ein kaputter Treiber, ein Kabel. Reparieren Sie sie, oder nehmen Sie sie aus dem Cluster.
- Eine Ursache, die bei jedem Versuch wiederkehrt. Fadenstack hört auf, es erneut zu versuchen, und meldet das (siehe unten).
- Der Server selbst: Speicherplatz, Zertifikate, Sicherungen. Die Liste Handlungsbedarf im Dashboard zeigt, was nicht stimmt.
Was die Meldungen einer Bereitstellung bedeuten
Die Seite einer Bereitstellung sagt in einer Zeile, was sie gerade tut. Die Meldungen, denen Sie begegnen werden:
| Meldung | Was sie bedeutet | Was zu tun ist |
|---|---|---|
| Downloading Modell to the Fadenstack server (…%). It is copied to the cluster as soon as it is there. | Der Server holt zuerst das Modell | Warten Sie, oder laden Sie es vorab im Modell-Marktplatz herunter |
| Downloading Modell to the Fadenstack server failed: … | Ein zugangsbeschränktes Modell ohne Token, ein falsch geschriebenes Repository | Beheben Sie das und wiederholen Sie dann den Download unter Modell-Marktplatz → Auf diesem Server |
| Copying the model to the machines again after a failed attempt. | Das Kopieren auf eine Maschine ist fehlgeschlagen und wird wiederholt | Warten Sie; schlägt es weiter fehl, prüfen Sie die Festplatte der Maschine |
| Serving on 1 of 2 copies; 1 more starting. | Einige Kopien laufen, die übrigen laden noch | Warten Sie |
| Serving on 2 of 3 copies. 1 cannot start: each copy needs 1 accelerator, and this cluster has 2, so 2 fit. Scale to 2, or add a machine to the cluster. | Es wurden mehr Kopien angefordert, als im Cluster Platz haben | Skalieren Sie herunter, oder fügen Sie eine Maschine hinzu |
| Waiting for Maschine to reconnect before applying. | Eine Maschine des Clusters ist offline | Bringen Sie die Maschine zurück |
| The cluster was restarted: applying the model again; its copies are starting. | Der Cluster wurde repariert; das Modell lädt neu | Warten Sie |
| A start failed: … Ray is trying again. | Die Engine konnte nicht starten; der Grund stammt von ihr selbst | Lesen Sie den Grund; ist es eine Einstellung, ändern Sie sie |
| Start failed: … Not tried again: this error comes back on every attempt. | Die Bereitstellung zeigt Fehlgeschlagen und versucht es nicht mehr | Ändern Sie, was der Grund nennt (z. B. die Engine-Einstellungen), dann wird sie erneut angewendet |
| Port … is already in use on this machine by another program; publish this model on another port. | Der Port des Modells ist auf der Maschine belegt | Geben Sie den Port frei, oder veröffentlichen Sie das Modell auf einem anderen |
Die häufigsten Startfehler sind ein Modell, das nicht in den Speicher der GPU passt, und ein Zahlenformat, das die Karte nicht unterstützt. Die Einstellungen einer Bereitstellung zu ändern ist Aufgabe des Administrators: siehe Bereitstellungen. Fehler anzeigen bei einer fehlgeschlagenen Bereitstellung öffnet ihr Log bei den Fehlern.
Logs lesen
In der Konsole
Logs (in der Navigation) sammelt die Logs aller Maschinen und der eigenen Dienste des Servers. Auf dem Reiter Systemprotokolle können Sie:
- einen Zeitraum wählen (Letzte 15 Min. bis Letzte 24 Std. oder Benutzerdefiniert) oder Live wählen, um neuen Zeilen zu folgen;
- nach Maschine, Quelle, Deployment, Komponente, Kopie, Dienst, Container und Stufe eingrenzen. Die Filter bieten nur an, was der gewählte Zeitraum enthält;
- den Text durchsuchen.
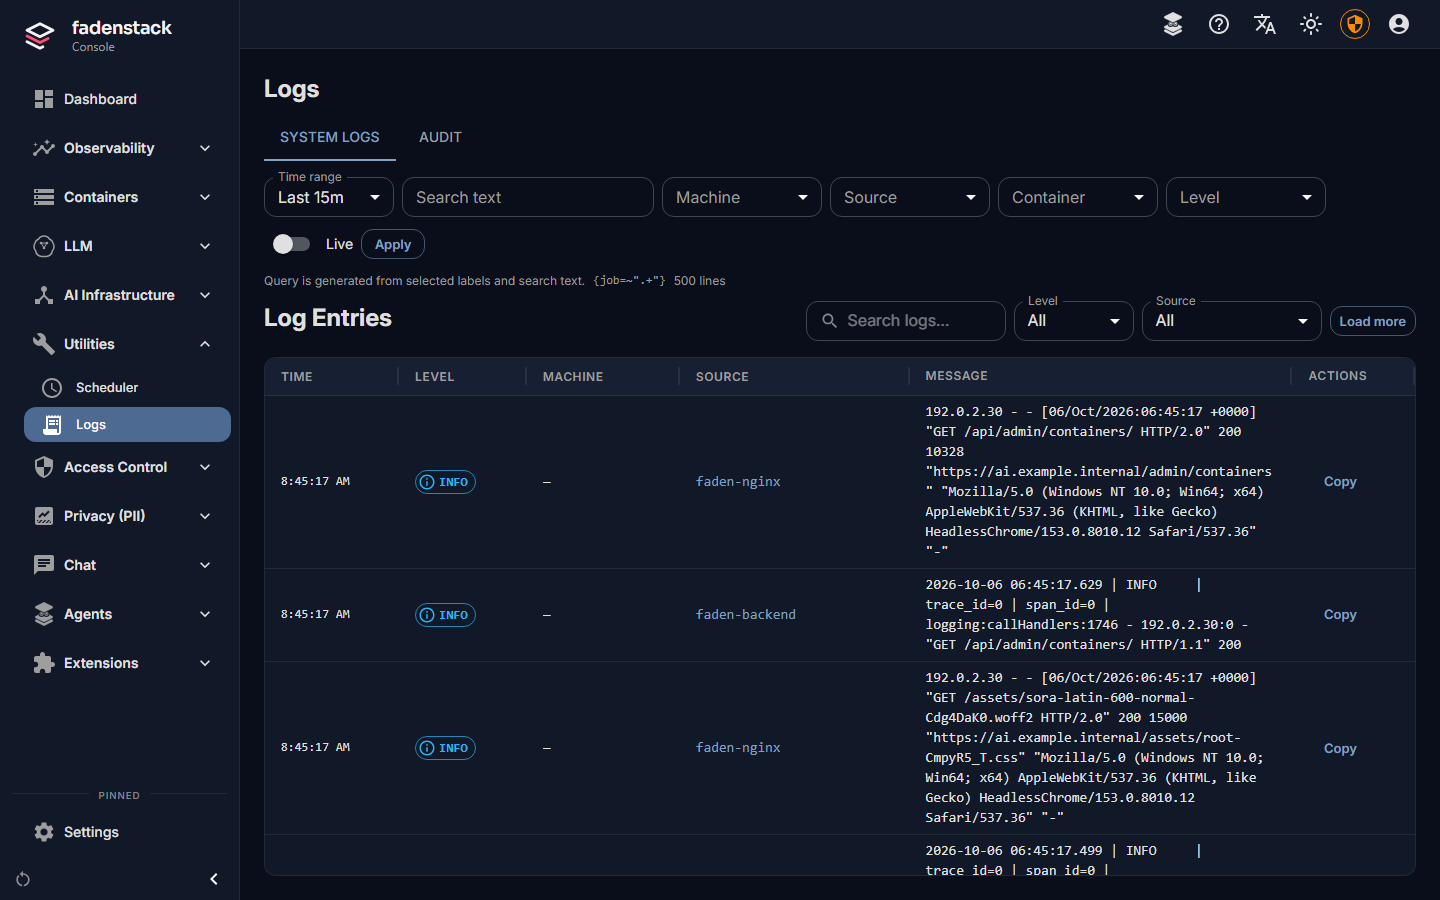
| Quelle | Was sie ist |
|---|---|
| Systemprotokoll | Das System-Journal einer Maschine: jeder Dienst darauf, auch der Agent |
| Modellbereitstellung | Die Modellkopien auf einem Cluster. Deployment und Komponente grenzen auf ein Modell ein |
| Fadenstack-Dienste | Die eigenen Container des Servers |
| Modell-Container | Modelle, die außerhalb eines Clusters als ein Container pro Modell laufen |
Der Reiter Audit listet auf, wer was geändert hat: die Aktion, ihr Ziel, ihr Ergebnis und wer sie ausgeführt hat.
An anderen Stellen zeigt die Konsole dieselben Logs dort, wo Sie sie brauchen:
- die Seite einer Maschine: ihre Systemprotokolle der letzten 15 Minuten und In Logs öffnen für den Rest;
- die Seite einer Bereitstellung: ihre Protokolle, mit den Zeilen der Modellbereitstellung und der Engine (vLLM), nach Stufe filterbar, durchsuchbar und mit Neuen Zeilen folgen, Angezeigte Zeilen kopieren und Angezeigte Zeilen herunterladen;
- die Seite eines Containers unter Container: seine letzten 300 Zeilen.
Die Modellkopien schreiben eine Zeile, wenn etwas geschieht (Start, Stopp, ein Fehler), nicht für jede Anfrage.
Maschinen senden ihre Logs über die normale Adresse des Servers, mit ihren eigenen Zugangsdaten; eine Zeile, die der Server nicht angenommen hat, wird später erneut gesendet. Auf den Maschinen muss nichts eingerichtet werden.
Metrik-Dashboards finden Sie in Grafana, das Sie aus der Konsole unter /grafana/ erreichen (die Seite eines
Clusters hat Metrik-Dashboard öffnen).
Auf dem Server
faden status                          # welche Dienste laufen und welche nicht gesund sind
faden logs faden-backend              # die letzten 100 Zeilen eines Dienstes
faden logs -f -n 200 faden-gateway    # neuen Zeilen folgen
faden logs --timestamps nginx postgres
Die Dienstnamen sind die aus faden status: faden-backend, faden-backend-worker, faden-gateway,
faden-frontend, nginx, postgres und so weiter. Die geplanten Aufgaben schreiben ihre Logs nach
~/fadenstack/backups/backup.log (Sicherungen) und ~/fadenstack/logs/tls-renew.log (Erneuerung der Zertifikate).
Auf einer Maschine
faden-agent status
journalctl -u faden-agent -f            # als Systemdienst
journalctl --user -u faden-agent -f     # als Benutzerdienst
faden-agent run führt den Agent im Vordergrund aus; so sehen Sie sofort, warum er keine Verbindung aufbaut. Stoppen
Sie vorher den Dienst.